Kurs içeriği (2 / 10)
- 1 Raspberry Pi ile Tanışma ve Kurulum
- 2 Makine Öğrenmesi Nedir? İlk Modelimiz
- 3 Kamera ve Görüntü İşlemenin Temelleri
- 4 Görüntü Veri Seti Hazırlama
- 5 Görüntü Tanıma Modeli Eğitip Pi’de Çalıştırma
- 6 Mikrofon ve Sesin Temelleri
- 7 Ses Veri Seti Hazırlama
- 8 Ses Tanıma Modeli ile Sesli Komutlar
- 9 Yapay Zekâyı Donanıma Bağlama: LED, Buzzer ve Servo
- 10 Mini Proje: Akıllı Geri Dönüşüm Kutusu
Raspberry Pi ile Makine Öğrenmesi: Görüntü ve Ses Tanıma · Ders 2 / 10
Makine Öğrenmesi Nedir? İlk Modelimiz
Kurallarla programlama ile verilerden öğrenme arasındaki farkı keşfediyoruz. Özellik, etiket, eğitim ve test verisi kavramlarını öğreniyor; scikit-learn ile Iris çiçek veri setinde ilk sınıflandırma modelimizi eğitip doğruluğunu ölçüyor, ardından kendi küçük veri setimizle bir karar ağacı kuruyoruz.
Bu derste
- Kurallarla programlama ile makine öğrenmesi arasındaki farkı açıklar.
- Özellik, etiket, eğitim verisi ve test verisi kavramlarını örnekle açıklar.
- scikit-learn ile bir veri setini eğitim ve test olarak ayırır.
- K-en yakın komşu (KNN) modelini eğitir, tahmin yaptırır ve doğruluğunu ölçer.
- Kendi küçük veri setiyle bir karar ağacı eğitir ve öğrenilen kuralları yorumlar.
Malzemeler
- Raspberry Pi (Ders 1’deki kurulum yapılmış)
- Thonny ve yzenv sanal ortamı
- scikit-learn (python3-sklearn)
Önceki derste Raspberry Pi’mizi hazırladık. Bu derste kamerayı ve mikrofonu bir kenara bırakıp işin temeline iniyoruz: Bir bilgisayar nasıl “öğrenir”? İlk modelimizi birkaç satır Python koduyla eğiteceğiz.
Dersin Amacı ve Kazanımlar
Bu dersin sonunda:
- Kurallarla programlama ile makine öğrenmesi arasındaki farkı açıklayabileceksiniz.
- Özellik, etiket, eğitim verisi ve test verisi kavramlarını örnekle açıklayabileceksiniz.
- scikit-learn ile bir veri setini eğitim ve test olarak ayırabileceksiniz.
- KNN modelini eğitip tahmin yaptırabilecek ve doğruluğunu ölçebileceksiniz.
- Kendi veri setinizle bir karar ağacı eğitip öğrenilen kuralları yorumlayabileceksiniz.
Gerekli Malzemeler
| Malzeme | Açıklama |
|---|---|
| Raspberry Pi 5 veya 4 | Ders 1’de kurulumu yapılmış hâliyle |
| Thonny | Yorumlayıcısı ~/yzenv/bin/python3 olarak ayarlanmış |
| scikit-learn | Ders 1’de python3-sklearn paketiyle kuruldu. Bu dersteki kodlar herhangi bir bilgisayarda da çalışır. |
💡 İpucu
Bu dersteki kodlar donanım gerektirmez. Pi’ler henüz hazır değilse aynı kodları okul bilgisayarlarında, scikit-learn kurulu herhangi bir Python ortamında da çalıştırabilirsiniz.
Kural mı Yazalım, Öğretelim mi?
Şimdiye kadar yazdığımız programlarda kuralları biz koyduk: “Not 50’den büyükse geçti yaz.” Peki bir fotoğrafta kedi olup olmadığını söyleyen bir program yazmak isteseydik? “Sivri kulak varsa kedidir” desek köpekler de sivri kulaklı olabilir. Kuralları tek tek yazmak imkânsıza yakındır.
Makine öğrenmesinde kuralları biz yazmayız. Bilgisayara çok sayıda örnek ve her örneğin doğru cevabını veririz; bilgisayar kuralı bu örneklerden kendisi çıkarır. Ortaya çıkan şeye model denir.
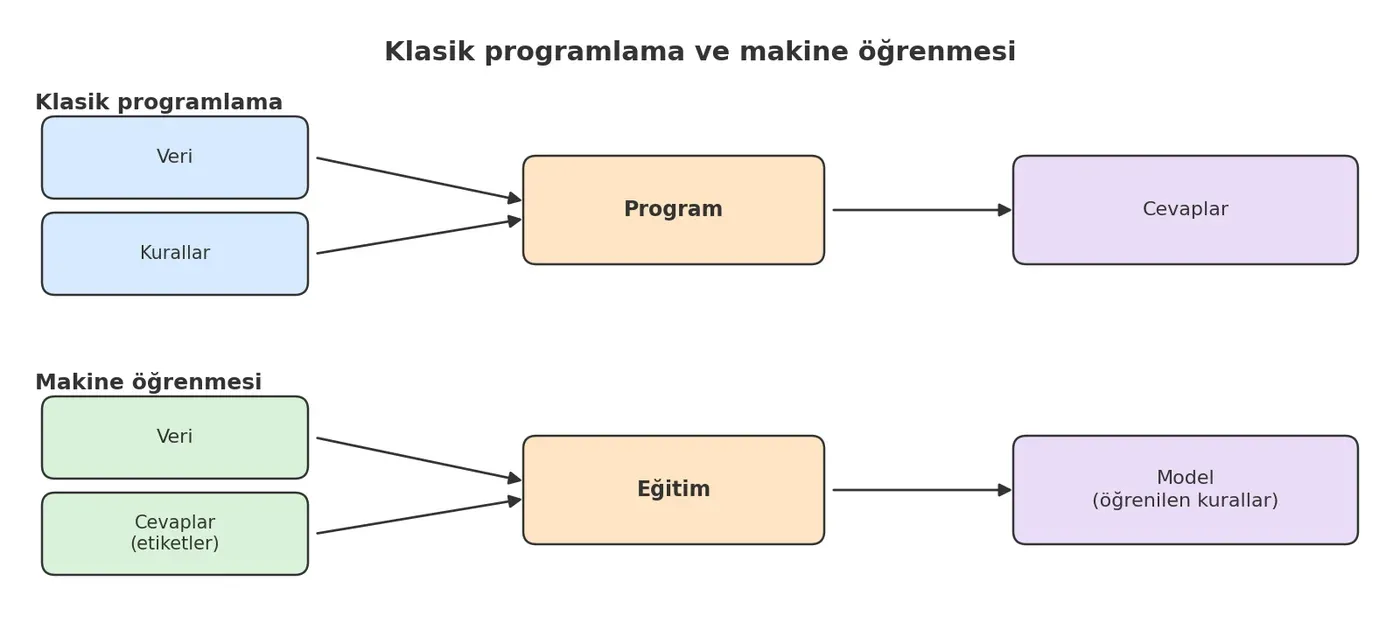
Birkaç temel kavram:
- Özellik (feature): Bir örneği anlatan ölçümler. Bir meyve için ağırlık ve renk, bir fotoğraf için piksel değerleri.
- Etiket (label): Örneğin doğru cevabı: “elma”, “portakal”, “kâğıt atık”.
- Eğitim verisi: Modelin öğrenirken gördüğü örnekler.
- Test verisi: Modelin hiç görmediği, başarıyı ölçmek için ayırdığımız örnekler. Sınavda ders kitabındaki soruların aynısını sormak gibi olmasın diye bu ayrımı yaparız.
- Sınıflandırma: Bir örneğin hangi gruba (sınıfa) ait olduğunu tahmin etmek. Bu kurstaki görüntü ve ses tanıma işlerinin hepsi birer sınıflandırmadır.
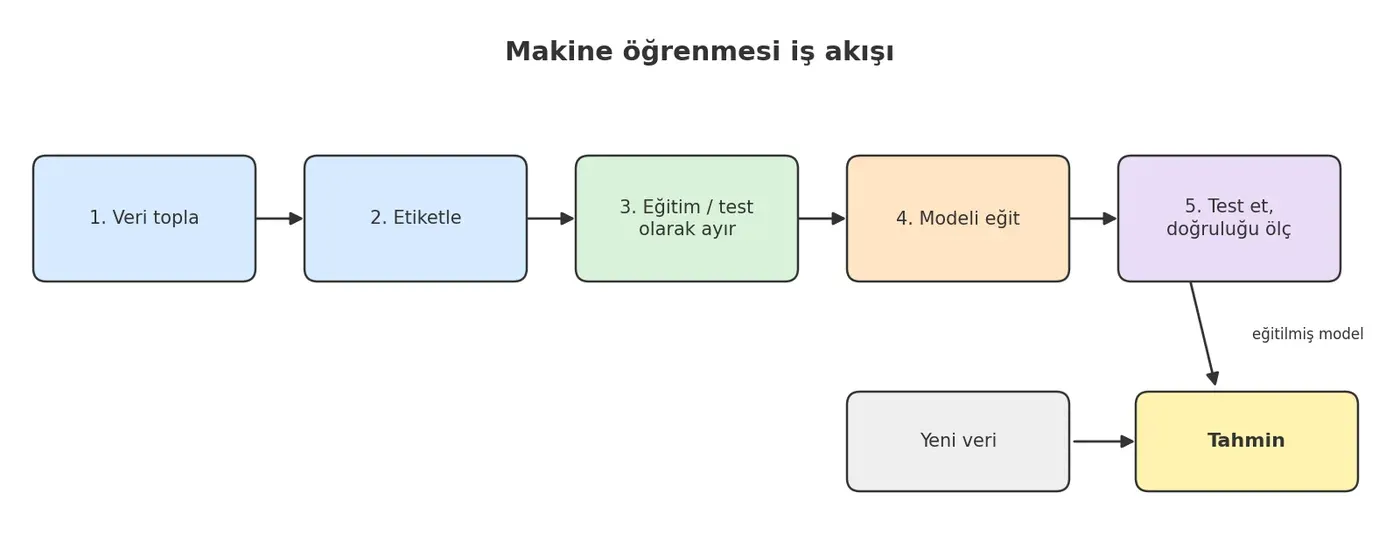
Iris Veri Seti
Makine öğrenmesinin “merhaba dünya”sı Iris veri setidir. Üç farklı türden (setosa, versicolor, virginica) 150 süsen çiçeğinin dört ölçümü vardır: çanak yaprak boyu ve eni, taç yaprak boyu ve eni. Veri seti scikit-learn ile birlikte gelir, internetten indirmeniz gerekmez.
Örnek 1: Veriyi Tanıma
# Iris veri setini tanıyalım
from sklearn.datasets import load_iris

iris = load_iris()
X = iris.data      # özellikler (ölçümler)
y = iris.target    # etiketler (çiçek türü numarası)

print("Veri boyutu:", X.shape)
print("Özellikler:", iris.feature_names)
print("Sınıflar:", list(iris.target_names))
print("İlk çiçeğin ölçümleri:", X[0], "→", iris.target_names[y[0]])
Beklenen çıktı:
Veri boyutu: (150, 4)
Özellikler: ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
Sınıflar: ['setosa', 'versicolor', 'virginica']
İlk çiçeğin ölçümleri: [5.1 3.5 1.4 0.2] → setosa
X 150 satır ve 4 sütundan oluşan bir tablodur: Her satır bir çiçek, her sütun bir özellik. y ise her çiçeğin türünü 0, 1 ve 2 sayılarıyla tutar. Özellik adları İngilizcedir: sepal çanak yaprak, petal taç yaprak demektir. Makine öğrenmesinde özellikleri büyük X, etiketleri küçük y ile göstermek bir gelenektir.
KNN: Komşuna Bak, Kim Olduğunu Söyleyeyim
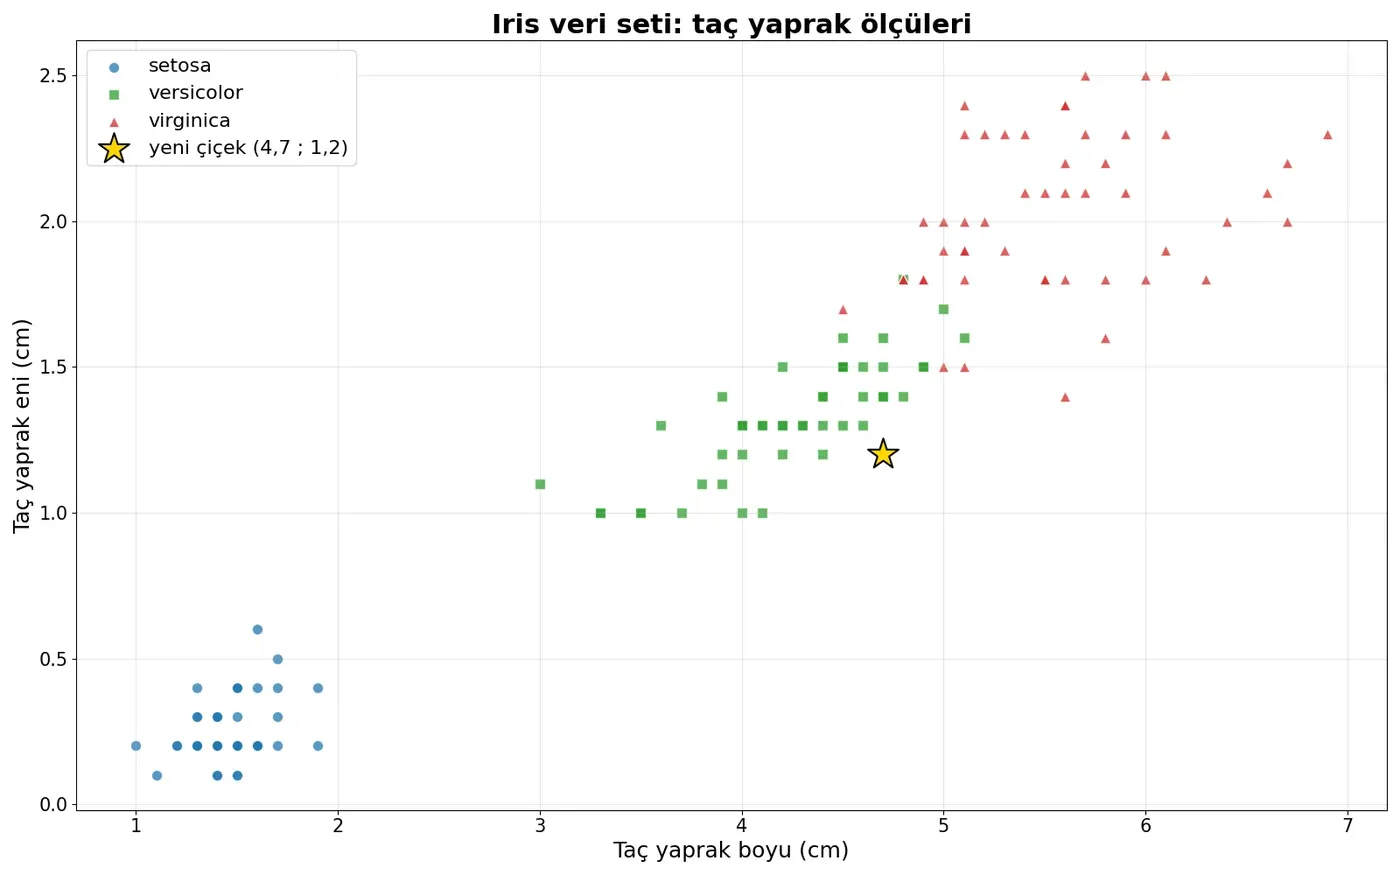
K-en yakın komşu (KNN) en kolay anlaşılan modellerden biridir. Yeni bir çiçek geldiğinde model, eğitim verisinde ona en çok benzeyen k çiçeğe bakar. Bu komşuların çoğunluğu hangi türdense yeni çiçeğe de o türü söyler. Yukarıdaki grafiğe bakın: Türler taç yaprak ölçülerine göre oldukça ayrı kümeler oluşturuyor. Bu yüzden komşulara bakmak iyi bir fikir.
Örnek 2: Eğit ve Test Et
# İlk modelimiz: K-en yakın komşu (KNN)
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

iris = load_iris()
X, y = iris.data, iris.target

# Verinin %80'i eğitim, %20'si test için ayrılıyor
X_egitim, X_test, y_egitim, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y)

model = KNeighborsClassifier(n_neighbors=5)
model.fit(X_egitim, y_egitim)        # öğrenme burada oluyor

tahminler = model.predict(X_test)    # modelin hiç görmediği çiçekler
print("Eğitim örneği:", len(X_egitim), "| Test örneği:", len(X_test))
print("Doğruluk:", accuracy_score(y_test, tahminler))
Beklenen çıktı:
Eğitim örneği: 120 | Test örneği: 30
Doğruluk: 1.0
Kodun üç önemli satırı var: train_test_split veriyi ayırır, fit modeli eğitir, predict tahmin yaptırır. random_state=42 ayırma işleminin her çalıştırmada aynı olmasını sağlar; böylece hepimiz aynı sonucu görürüz. stratify=y ise test verisinde her türden eşit sayıda çiçek olmasını garanti eder. Doğruluk 1.0 çıktı; yani model 30 test çiçeğinin hepsini doğru bildi. Her projede bu kadar yüksek bir sonuç beklemeyin: Iris, türleri birbirinden kolay ayrılan bir veri setidir.
Örnek 3: Yeni Bir Çiçek
# Yeni bir çiçeğin türünü tahmin edelim
from sklearn.datasets import load_iris
from sklearn.neighbors import KNeighborsClassifier

iris = load_iris()
model = KNeighborsClassifier(n_neighbors=5)
model.fit(iris.data, iris.target)

# çanak yaprak boyu, çanak yaprak eni, taç yaprak boyu, taç yaprak eni (cm)
yeni_cicek = [[6.1, 2.8, 4.7, 1.2]]
sonuc = model.predict(yeni_cicek)[0]
olasiliklar = model.predict_proba(yeni_cicek)[0]

print("Tahmin:", iris.target_names[sonuc])
for ad, p in zip(iris.target_names, olasiliklar):
    print(f"  {ad:<10} %{p * 100:.0f}")
Beklenen çıktı:
Tahmin: versicolor
  setosa     %0
  versicolor %100
  virginica  %0
predict_proba her sınıf için bir olasılık verir. KNN’de bu olasılık, komşuların oylarıdır: Beş komşunun beşi de versicolor ise olasılık %100 olur. İlerleyen derslerde görüntü modelimiz de bize böyle bir güven puanı verecek ve “emin değilim” demeyi bu puanla öğreteceğiz.
Kendi Veri Setimiz ve Karar Ağacı
Hazır veri setleri güzel ama asıl güç kendi verimizi toplamakta. On meyveyi tarttığımızı ve kabuklarının pürüzlü olup olmadığını not ettiğimizi düşünelim. Bu kez karar ağacı kullanacağız. Karar ağacı, verideki örnekleri en iyi ayıran evet/hayır sorularını kendisi bulur. En güzel yanı, öğrendiği kuralları bize okunabilir biçimde gösterebilmesidir.
Örnek 4: Elma mı, Portakal mı?
# Kendi veri setimiz: Elma mı, portakal mı?
from sklearn.tree import DecisionTreeClassifier, export_text

# Özellikler: [ağırlık (gram), kabuk (0 = pürüzsüz, 1 = pürüzlü)]
X = [[140, 0], [130, 0], [150, 0], [170, 0], [125, 0],
     [160, 1], [180, 1], [200, 1], [190, 1], [175, 1]]
y = ["elma", "elma", "elma", "elma", "elma",
     "portakal", "portakal", "portakal", "portakal", "portakal"]

agac = DecisionTreeClassifier(random_state=0)
agac.fit(X, y)

print(export_text(agac, feature_names=["agirlik", "kabuk"]))
print("165 g, pürüzlü kabuk →", agac.predict([[165, 1]])[0])
print("165 g, pürüzsüz kabuk →", agac.predict([[165, 0]])[0])
Beklenen çıktı:
|--- kabuk <= 0.50
|   |--- class: elma
|--- kabuk >  0.50
|   |--- class: portakal

165 g, pürüzlü kabuk → portakal
165 g, pürüzsüz kabuk → elma
Model ağırlığa hiç bakmadan yalnızca kabuğa göre karar vermeyi öğrendi, çünkü bizim on örneğimizde kabuk tek başına yetiyordu. Bu, makine öğrenmesinin önemli bir gerçeğini gösteriyor: Model, ona verdiğimiz veride ne varsa onu öğrenir. Veri setimizde pürüzsüz kabuklu bir portakal hiç olmadığı için model “pürüzsüz = elma” kuralını çıkardı. Gerçek hayatta bu kural yanlış olabilir.
⚠️ Önemli Not
Modeli asla eğitim verisiyle test etmeyin. Eğitimde gördüğü örnekleri sormak, cevap anahtarını önceden vermiş olduğunuz bir sınav gibidir; çıkan yüksek doğruluk sizi yanıltır. Her zaman train_test_split ile bir test kümesi ayırın ve başarıyı yalnızca o kümede ölçün.
Sıra Sizde
- Kolay: Örnek 2’de
n_neighborsdeğerini 1, 3, 7 ve 15 yaparak doğruluğu tekrar ölçün. Sonuçları bir tabloya yazın. - Orta: Örnek 4’teki veri setine 120 gram ağırlığında, pürüzlü kabuklu küçük bir mandalinayı “portakal” etiketiyle ekleyin. Karar ağacının kuralları değişti mi? Neden?
- Zor: Sınıfınızdan en az 20 kişiden iki özellik toplayın (ör. boy ve ayakkabı numarası) ve bir etiket belirleyin (ör. “basketbol takımında mı?”). Veriyle bir karar ağacı eğitip kurallarını
export_textile yazdırın. Kişisel verileri isimsiz tutmayı unutmayın.
Kendini Dene
- Bir fotoğraftaki atığın türünü tahmin eden modelde “özellik” ve “etiket” nedir?
model.fit()vemodel.predict()komutları ne iş yapar?- Bir öğrenci modelini eğitim verisiyle test edip %100 doğruluk buldu. Bu sonuca neden güvenmemeliyiz?
Cevaplar
- Özellik fotoğrafın piksel değerleridir; etiket ise atığın türüdür (kâğıt, plastik, metal gibi).
fit()modeli eğitim verisiyle eğitir;predict()eğitilmiş modelle yeni örnekler için tahmin yapar.- Çünkü model o örnekleri eğitimde zaten gördü; ezberlemiş olabilir. Gerçek başarıyı ancak hiç görmediği test verisiyle ölçebiliriz.